Редакция «Базы компаний» · · 32 мин чтения
Руководство для B2B-маркетолога по парсингу социальных сетей для лидогенерации
Введение: соблазнительная песнь бесконечных лидов В современном мире B2B-продаж и …
Содержание статьи
- Введение: соблазнительная песнь бесконечных лидов
- Глава 1: Демистификация веб-парсинга: руководство по извлечению данных для менеджеров
- 1.1 Что такое веб-парсинг? От ручного копирования к автоматизированным ботам
- 1.2 Инструментарий парсера: от простых расширений до кастомных скриптов
- 1.3 Как это работает: четырехэтапный процесс автоматического извлечения данных
- Знакомство с «безголовыми» браузерами
- Глава 2: Юридический и этический канат: парсинг социальных сетей
- 2.1 Ключевой конфликт: почему «общедоступно» не означает «свободно для любого использования»
- 2.2 Читаем мелкий шрифт: что прямо запрещают социальные платформы
- 2.3 Испытание GDPR: парсинг персональных данных в Европе
- 2.4 Прецедентное дело: сага hiQ против LinkedIn
- Глава 3: Технические тонкости: как парсить социальные сети
- 3.1 Игра в кошки-мышки: обзор техник защиты от парсинга
- 3.2 Парсинг LinkedIn: «Форт-Нокс» социальных сетей
- Пример кода: простой парсер публичного профиля на Python
- 3.3 Парсинг Facebook: «сад за стеной»
- Пример кода: извлечение постов из общедоступной группы Facebook
- 3.4 Парсинг ВКонтакте: API-ориентированный подход
- Пример кода: базовый запрос к VK API
- Глава 4: От сырых данных к качественным лидам: B2B-стратегия
- 4.1 Определение цели: использование должностей и фирмографики для идентификации ЛПР
- 4.2 Опасности холодных рассылок: почему ваш спарсенный список может обернуться против вас
- 4.3 Скрытый враг: как устаревание данных делает ваш список бесполезным
- Глава 5: Безопасные гавани: мощные альтернативы ручному парсингу
- 5.1 Официальный путь: использование LinkedIn Sales Navigator
- 5.2 Аутсорсинговый путь: обзор поставщиков B2B-данных
- 5.3 Устойчивый путь: основы входящей (inbound) лидогенерации
- Заключение: парсить или не парсить? Окончательный вердикт для современного B2B-маркетолога
- Источники
Введение: соблазнительная песнь бесконечных лидов
В современном мире B2B-продаж и маркетинга давление на команды огромно. Необходимость постоянно пополнять воронку продаж качественными лидами заставляет искать все новые и новые источники данных. В этом контексте парсинг (или скрейпинг) социальных сетей предстает как мощное, почти магическое решение — прямой путь к неисчерпаемому источнику контактной информации. Идея о том, чтобы автоматически собрать данные о тысячах лиц, принимающих решения (ЛПР), с таких платформ, как LinkedIn, Facebook или ВКонтакте, звучит как воплощение мечты любого B2B-специалиста.
Однако за этой соблазнительной песней скрывается суровая реальность. Хотя технически парсинг вполне осуществим, он представляет собой высокорискованное предприятие, сопряженное с серьезными юридическими, этическими и практическими проблемами, которые зачастую перевешивают потенциальные выгоды. Это путь, усеянный подводными камнями, где один неверный шаг может привести к судебным искам, блокировке домена и непоправимому ущербу для репутации компании.
Цель этого исследования — не просто дать инструкцию по парсингу, а предоставить всесторонний стратегический анализ для руководителей бизнеса. Мы проведем вас через все этапы этого сложного процесса: от основ технологии и юридических тонкостей до рисков и, что самое важное, к более безопасным и эффективным стратегиям роста. Это сбалансированный и исчерпывающий обзор, который поможет принять взвешенное решение, основанное на фактах, а не на мифах о «легких» лидах.
Глава 1: Демистификация веб-парсинга: руководство по извлечению данных для менеджеров
Прежде чем погружаться в юридические и стратегические дебри, необходимо понять, что представляет собой технология парсинга. Этот раздел заложит нетехнический фундамент, который позволит любому читателю разобраться в основных механиках процесса.
1.1 Что такое веб-парсинг? От ручного копирования к автоматизированным ботам
В своей основе веб-парсинг (web scraping) — это автоматизированный процесс сбора данных с веб-сайтов.1 Представьте, что вы наняли армию сверхбыстрых стажеров, которым поручили скопировать информацию с тысяч веб-страниц и внести ее в одну организованную электронную таблицу. Парсинг делает то же самое, но с помощью специальных программ, которые называют «ботами», «пауками» или «краулерами».1
Важно различать два смежных понятия:
- Краулинг (crawling): это процесс обнаружения URL-адресов на сайте путем перехода по ссылкам. Именно так поисковые системы, такие как Google, индексируют интернет. Краулер «ползает» по сети, создавая карту страниц.1
- Парсинг (scraping): это целенаправленное извлечение конкретной информации с уже известных страниц. Если краулинг — это составление карты города, то парсинг — это запись адресов всех библиотек на этой карте.1
Таким образом, парсинг — это технология, которая преобразует неструктурированные данные из интернета (текст, изображения, ссылки на веб-страницах) в структурированный и удобный для использования формат, например, в таблицу CSV, JSON-файл или базу данных.1
1.2 Инструментарий парсера: от простых расширений до кастомных скриптов
Парсинг не является монолитной технологией; для его реализации существует целый спектр инструментов, различающихся по сложности и возможностям.
- Браузерные расширения: Это самый простой способ начать. Такие расширения устанавливаются как плагины для браузера (например, Chrome) и часто имеют интуитивно понятный интерфейс «point-and-click» («укажи и нажми»). Они хорошо подходят для небольших, разовых задач, но их функциональность и масштабируемость ограничены.2
- Платформы No-Code/Low-Code (например, Octoparse, Apify): Это визуальные конструкторы, которые позволяют создавать парсеры без написания кода. Пользователь просто указывает на нужные элементы на странице, а платформа генерирует логику для их извлечения. Эти инструменты представляют собой популярный компромисс между простотой и мощностью.4
- Кастомные парсеры (программные фреймворки): Наиболее мощный и гибкий вариант, требующий навыков программирования. Разработчики используют языки, такие как Python, и специализированные библиотеки (например, BeautifulSoup, Scrapy, Selenium, Puppeteer) для создания сложных парсеров, способных обрабатывать огромные объемы данных и обходить защитные механизмы сайтов. Этот подход используется для серьезных, крупномасштабных проектов.2
Доступность no-code инструментов создает опасную иллюзию простоты и законности. Пользователь без технических знаний может легко начать парсить данные, не имея ни малейшего представления о юридических или этических последствиях. Инструмент абстрагирует риск, делая процесс кажущимся безобидным и санкционированным. В действительности, пользователь может оказаться в ситуации, когда он владеет данными, полученными с нарушением Условий использования платформы и, возможно, законов о защите данных, таких как GDPR, при этом не написав ни единой строчки кода и не прочитав ни одного юридического документа. Легкость использования современных инструментов для парсинга является значительным фактором риска, поскольку она снижает порог входа для участия в юридически опасной деятельности.
1.3 Как это работает: четырехэтапный процесс автоматического извлечения данных
Процесс парсинга можно разбить на четыре основных этапа, которые проходит бот для сбора информации 1:
- Запрос страницы: Парсер отправляет HTTP-запрос на целевой URL-адрес, точно так же, как это делает ваш веб-браузер, когда вы вводите адрес сайта. В ответ сервер отправляет исходный код страницы в формате HTML.1
- Разбор (парсинг) кода: Получив HTML-код, программа-парсер «просеивает» его, чтобы найти конкретные данные, которые ей поручили извлечь. Например, она может искать текст внутри тега <h1> (заголовок) или <div> с определенным классом, таким как «job-title». На этом этапе отлично проявляют себя библиотеки вроде BeautifulSoup.2
- Извлечение данных: Бот копирует найденную информацию (имя, должность, название компании и т.д.).
- Структурирование и сохранение: Извлеченные данные организуются в чистый формат (например, в виде таблицы) и сохраняются в файл (CSV, JSON) для дальнейшего анализа или использования.1
Знакомство с «безголовыми» браузерами
Современные веб-сайты, особенно социальные сети, очень динамичны. Большая часть контента (например, лента новостей или список контактов) подгружается с помощью JavaScript уже после того, как основная страница загрузилась. Простые парсеры, которые читают только первоначальный HTML-код, не увидят эти данные.
Здесь на сцену выходят так называемые «безголовые» браузеры (headless browsers), такие как Selenium и Puppeteer.7 Представьте себе браузер-призрак, который работает невидимо в фоновом режиме. У него нет графического интерфейса (окна, кнопок), но он может делать все то же, что и обычный браузер: нажимать на кнопки, прокручивать страницу вниз, заполнять формы и выполнять JavaScript-код. Это делает их незаменимыми для парсинга сложных, интерактивных сайтов, таких как LinkedIn или Facebook.8
Глава 2: Юридический и этический канат: парсинг социальных сетей
Эта глава — краеугольный камень всего исследования. Она представляет собой подробный и предостерегающий анализ правового поля, в котором существует парсинг данных.
2.1 Ключевой конфликт: почему «общедоступно» не означает «свободно для любого использования»
Самое распространенное и опасное заблуждение относительно парсинга заключается в том, что если информация видна всем в интернете, ее можно свободно собирать и использовать в любых целях, особенно в коммерческих.10 Это в корне неверно.
Тот факт, что пользователь разместил свои данные (например, должность и место работы) в открытом доступе на LinkedIn, не означает, что он дал согласие на их автоматический сбор и включение в списки для холодных рассылок.10 Законы о защите данных, такие как GDPR, защищают персональные данные независимо от их общедоступности. Ключевое значение имеет контекст, в котором данные были опубликованы. Пользователь делится своей профессиональной информацией для нетворкинга и поиска работы, а не для того, чтобы стать мишенью для нежелательной рекламы.10
2.2 Читаем мелкий шрифт: что прямо запрещают социальные платформы
Чтобы не быть голословными, обратимся к официальным документам — Условиям использования (Terms of Service, ToS) самих платформ. Они не оставляют места для двусмысленности.
- LinkedIn: Пользовательское соглашение LinkedIn прямо и строго запрещает парсинг. Любое автоматизированное извлечение данных является нарушением правил платформы.14 Это положение является юридической основой для судебных исков и технических мер защиты, которые компания активно применяет.
- Facebook (Meta): Условия использования Meta предельно ясны: «Вы не имеете права осуществлять доступ к нашим Продуктам или сбор данных из них с помощью автоматизированных средств (без нашего предварительного разрешения)».16 Единственным разрешенным способом программного доступа к данным являются официальные API платформы. Meta даже предоставляет разработчикам инструкции, как проверить свой код на предмет нарушений.16
- ВКонтакте: Хотя прямой парсинг также запрещен общими правилами платформы, основным предполагаемым методом для программного доступа к данным является официальный API.19 Условия использования подробно описывают, какие данные и для каких целей собирает сама платформа, подразумевая, что иное использование не санкционировано.20
Чтобы наглядно продемонстрировать позицию каждой платформы, приведем сводную таблицу.
| Таблица 1: Позиция социальных платформ по автоматизированному сбору данных |
| Платформа |
| Facebook (Meta) |
| ВКонтакте |
Эта таблица не оставляет сомнений: парсинг в обход официальных инструментов является прямым нарушением договора, который каждый пользователь заключает с платформой при регистрации.
2.3 Испытание GDPR: парсинг персональных данных в Европе
Общий регламент по защите данных (GDPR) — это мощный законодательный акт Европейского союза, который кардинально меняет правила игры для всех, кто работает с персональными данными европейцев.
- Чьи данные? GDPR защищает персональные данные любого человека, находящегося на территории ЕС или Великобритании, независимо от того, где расположена компания, которая эти данные собирает или обрабатывает.10
- Что такое персональные данные? Имена, адреса электронной почты, должности, фотографии, IP-адреса — то есть все те данные, которые так привлекают B2B-маркетологов.
- Требование «законного основания»: Это центральная концепция GDPR. Для обработки персональных данных у вас должно быть веское юридическое основание. Из шести законных оснований для парсинга в маркетинговых целях наиболее релевантны два 10:
- Согласие: Это «золотой стандарт». Вы должны получить явное, недвусмысленное и свободно данное согласие от каждого человека из вашего списка до того, как вы начнете парсить его данные для маркетинговых целей. Для крупномасштабного парсинга это практически невыполнимая задача.10
- Законный интерес: Наиболее гибкое, но и самое рискованное основание. Оно требует проведения и документирования специальной оценки (Legitimate Interests Assessment, LIA), доказывающей, что ваш коммерческий интерес в парсинге данных не превалирует над фундаментальным правом человека на неприкосновенность частной жизни. Достичь такого баланса в случае с нежелательным маркетингом крайне сложно.10
Другие основания (исполнение контракта, юридическое обязательство и т.д.) в данном контексте практически неприменимы.10
- Ограничение цели и прозрачность: GDPR требует, чтобы данные собирались для заранее определенных, явных и законных целей. Вы не можете собрать данные под одним предлогом, а затем использовать их для совершенно другой цели. Кроме того, статья 14 GDPR обязывает вас информировать людей о том, что вы собрали их данные (даже если вы получили их не напрямую), что является еще одним серьезным препятствием для «невидимого» парсинга.11
По сути, GDPR делает цель пользователя — парсинг социальных сетей для создания списков холодных рассылок — юридически несостоятельной на территории Европы. Препятствия, такие как получение предварительного согласия от миллионов людей или обоснование «законного интереса» для нежелательного маркетинга, специально созданы так, чтобы быть непреодолимыми для подобной деятельности. Регуляторы, такие как ICO в Великобритании, неоднократно подчеркивали, что пользователи не ожидают, что их общедоступные данные будут собираться для посторонних коммерческих целей.12 Любая попытка оправдать такой парсинг «законным интересом» почти наверняка провалится при проверке регулятором. Это не «серая зона», а прямое нарушение духа и буквы закона.
2.4 Прецедентное дело: сага hiQ против LinkedIn
История судебного противостояния между небольшой аналитической компанией hiQ Labs и гигантом LinkedIn является самым важным уроком для любого бизнеса, рассматривающего возможность парсинга.
- Действующие лица: hiQ Labs — стартап, который парсил общедоступные профили LinkedIn для создания «аналитики персонала» для работодателей (например, предсказывал, какие сотрудники могут скоро уволиться). LinkedIn — платформа, которая стремилась это прекратить.22
- Начало конфликта: LinkedIn отправляет hiQ письмо с требованием прекратить деятельность (cease-and-desist). В ответ hiQ подает в суд на LinkedIn, чтобы помешать последней применить против нее американский Закон о компьютерном мошенничестве и злоупотреблениях (CFAA) — по сути, антихакерский закон.22
- Решение Девятого округа (громкая новость): Апелляционный суд встал на сторону hiQ. Суд постановил, что положение CFAA о «несанкционированном доступе» подобно «взлому и проникновению». Если сайт является общедоступным (не защищен паролем), то доступ к нему не может быть «несанкционированным». Таким образом, парсинг общедоступных данных не является преступлением по закону CFAA.24 Эта новость была воспринята многими как «зеленый свет» для парсинга.
- Ключевой поворот (окончательный вердикт): Но на этом дело не закончилось. Несмотря на решение по CFAA, судебный процесс продолжался. В конечном итоге, окружной суд постановил, что hiQ все равно нарушила свой контракт с LinkedIn, поскольку нарушила Пользовательское соглашение (которое запрещает парсинг). В итоге hiQ пошла на мировое соглашение, согласившись на постоянный судебный запрет на свою деятельность и выплату компенсации.21
Итог дела hiQ против LinkedIn — это важнейший урок. Он создает критически важное юридическое различие: вас, возможно, не посадят в тюрьму за парсинг общедоступных данных (это не преступление по CFAA), но вас абсолютно точно могут довести до банкротства иском о нарушении договора. Многие, прочитав заголовки о том, что «суд разрешил парсить открытые сайты», ошибочно восприняли это как полную легализацию. Они упустили из виду финальный результат дела, где решающим аргументом стало именно нарушение Условий использования. Этот прецедент дал платформам, таким как LinkedIn, проверенный юридический сценарий для прекращения деятельности парсеров: письмо с требованием прекратить, а затем — иск о нарушении контракта с требованием возмещения убытков. Нюансы этого дела превращают парсинг в настоящее минное поле.
Глава 3: Технические тонкости: как парсить социальные сети
Этот раздел предоставляет запрошенную техническую информацию, но в образовательном ключе — чтобы показать сложность и «игру в кошки-мышки», а не как прямое руководство к действию.
Отказ от ответственности: Следующий раздел предоставлен исключительно в образовательных и иллюстративных целях. Парсинг данных с обсуждаемых платформ является прямым нарушением их Условий использования и может повлечь за собой значительные юридические и финансовые риски. Примеры кода упрощены для демонстрации механики и не предназначены для использования в реальных проектах.
3.1 Игра в кошки-мышки: обзор техник защиты от парсинга
Веб-сайты не сидят сложа руки; они активно борются с автоматическим сбором данных. Понимание этих методов защиты крайне важно, чтобы осознать, что парсинг — это не простая, разовая задача, а постоянная борьба.
| Таблица 2: Распространенные методы защиты от парсинга и тактики обхода |
| Механизм защиты |
| Блокировка по IP и ограничение частоты запросов |
| CAPTCHA |
| Динамический HTML и JavaScript |
| Анализ поведения пользователя |
| Требование авторизации (Login Wall) |
Эта таблица наглядно демонстрирует «гонку вооружений» между платформами и парсерами. Это не разовая настройка, а постоянная, дорогостоящая битва за обход все более изощренных систем защиты.
3.2 Парсинг LinkedIn: «Форт-Нокс» социальных сетей
LinkedIn известен как одна из самых сложных для парсинга платформ. Это связано с серьезными инвестициями компании в технологии защиты от ботов и ее юридической готовностью преследовать нарушителей.27
Пример кода: простой парсер публичного профиля на Python
В этом примере используются библиотеки Selenium для управления браузером и BeautifulSoup для разбора HTML.
Python
# Внимание: Этот код является упрощенной демонстрацией и нарушает Условия использования LinkedIn.
# Не используйте его в реальных проектах.

from selenium import webdriver
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.common.by import By
from selenium.webdriver.chrome.options import Options
from bs4 import BeautifulSoup
import time
import json

# --- Конфигурация ---
# Путь к chromedriver
DRIVER_PATH = '/path/to/chromedriver'
# Учетные данные (лучше хранить в отдельном файле)
LINKEDIN_USER = 'your_email@example.com'
LINKEDIN_PASS = 'your_password'
# URL профиля для парсинга
PROFILE_URL = 'https://www.linkedin.com/in/some-public-profile/'

# --- Настройка Selenium ---
chrome_options = Options()
# chrome_options.add_argument("--headless") # Безголовый режим может быть обнаружен
service = Service(DRIVER_PATH)
driver = webdriver.Chrome(service=service, options=chrome_options)

try:
    # --- Шаг 1: Авторизация ---
    driver.get('https://www.linkedin.com/login')
    time.sleep(2) # Даем странице загрузиться

    username_field = driver.find_element(By.ID, 'username')
    username_field.send_keys(LINKEDIN_USER)

    password_field = driver.find_element(By.ID, 'password')
    password_field.send_keys(LINKEDIN_PASS)

    driver.find_element(By.XPATH, '//*[@type="submit"]').click()
    time.sleep(5) # Ждем завершения входа и возможной переадресации

    # --- Шаг 2: Переход на страницу профиля ---
    driver.get(PROFILE_URL)
    time.sleep(5) # Даем странице профиля полностью загрузиться

    # --- Шаг 3: Получение и парсинг HTML ---
    page_source = driver.page_source
    soup = BeautifulSoup(page_source, 'html.parser')

    # --- Шаг 4: Извлечение данных ---
    # Примечание: Классы и теги могут часто меняться LinkedIn!
    # Этот код может быстро устареть.
    try:
        name = soup.find('h1', class_='text-heading-xlarge').get_text(strip=True)
    except:
        name = "Имя не найдено"

    try:
        title = soup.find('div', class_='text-body-medium').get_text(strip=True)
    except:
        title = "Должность не найдена"

    try:
        location = soup.find('span', class_='text-body-small inline t-black--light break-words').get_text(strip=True)
    except:
        location = "Местоположение не найдено"

    profile_data = {
        'name': name,
        'title': title,
        'location': location,
        'url': PROFILE_URL
    }

    print("Собранные данные:")
    print(profile_data)

    # --- Шаг 5: Сохранение в JSON ---
    with open('linkedin_profile.json', 'w', encoding='utf-8') as f:
        json.dump(profile_data, f, ensure_ascii=False, indent=4)
    print("Данные сохранены в linkedin_profile.json")


finally:
    # --- Завершение работы ---
    driver.quit()
Этот код, основанный на логике из нескольких репозиториев на GitHub 35, демонстрирует ключевые этапы: авторизация, навигация и извлечение данных с помощью поиска по HTML-тегам. Важно понимать, что LinkedIn постоянно меняет верстку своих страниц, поэтому такой парсер требует постоянной поддержки и обновления.
3.3 Парсинг Facebook: «сад за стеной»
Facebook представляет собой «сад за стеной» (walled garden), где большая часть ценной информации скрыта за требованием авторизации. Парсинг часто требует имитации действий залогиненного пользователя, что является грубым нарушением Условий использования.28 Общедоступные страницы и группы более доступны, но также защищены.
Пример кода: извлечение постов из общедоступной группы Facebook
Для этой задачи можно использовать готовую Python-библиотеку facebook-scraper.
Python
# Внимание: Этот код является демонстрацией и нарушает Условия использования Facebook.
# Для доступа к большинству групп требуется авторизация (cookies).

from facebook_scraper import get_posts
import json

# --- Конфигурация ---
# ID группы (можно найти в URL группы)
GROUP_ID = 'some_public_group_id'
# Количество страниц с постами для парсинга
PAGES_TO_SCRAPE = 3
# Путь к файлу с cookies для авторизации
# Без этого файла парсинг, скорее всего, не сработает.
# Cookies можно получить из браузера с помощью расширений.
COOKIES_FILE = 'facebook_cookies.json'

posts_data =

try:
    # --- Шаг 1: Парсинг постов ---
    # Параметр 'group' указывает, что мы парсим группу.
    # Параметр 'cookies' необходим для аутентификации.
    for post in get_posts(group=GROUP_ID, pages=PAGES_TO_SCRAPE, cookies=COOKIES_FILE):
        print(f"Парсинг поста ID: {post['post_id']}")
        posts_data.append({
            'post_id': post['post_id'],
            'text': post['text'],
            'time': post['time'].isoformat() if post['time'] else None,
            'user_id': post['user_id'],
            'likes': post['likes'],
            'comments': post['comments'],
            'shares': post['shares']
        })

    # --- Шаг 2: Сохранение в JSON ---
    with open('facebook_group_posts.json', 'w', encoding='utf-8') as f:
        json.dump(posts_data, f, ensure_ascii=False, indent=4)
    print(f"\nСобрано {len(posts_data)} постов. Данные сохранены в facebook_group_posts.json")

except Exception as e:
    print(f"Произошла ошибка: {e}")
    print("Возможно, требуются действительные cookies или группа является закрытой.")
Этот пример, основанный на документации библиотеки facebook-scraper 34, подчеркивает ключевой момент: даже при использовании специализированных инструментов, аутентификация (через cookies) часто является обязательным условием для успешного парсинга.
3.4 Парсинг ВКонтакте: API-ориентированный подход
В отличие от LinkedIn и Facebook, которые активно препятствуют любому доступу, кроме как через API, ВКонтакте имеет более открытый и документированный API. Хотя прямой парсинг HTML-страниц также запрещен, использование API является санкционированным методом программного доступа.
Пример кода: базовый запрос к VK API
Для этого примера достаточно стандартной библиотеки requests в Python.
Python
# Этот код демонстрирует легитимное использование VK API.

import requests
import json

# --- Конфигурация ---
# Ваш сервисный ключ доступа (access token).
# Его необходимо получить в настройках вашего приложения VK.
ACCESS_TOKEN = 'your_vk_service_access_token'
# Версия API
API_VERSION = '5.131'
# ID пользователя для получения информации
USER_ID = '1' # Павел Дуров

# --- Шаг 1: Формирование URL запроса ---
# Используем метод 'users.get' для получения информации о пользователе
method_name = 'users.get'
url = f'https://api.vk.com/method/{method_name}'

# --- Шаг 2: Определение параметров запроса ---
params = {
    'user_ids': USER_ID,
    'fields': 'bdate,city,country,domain', # Запрашиваемые поля
    'access_token': ACCESS_TOKEN,
    'v': API_VERSION
}

try:
    # --- Шаг 3: Отправка GET-запроса ---
    response = requests.get(url, params=params)
    response.raise_for_status() # Проверка на ошибки HTTP

    # --- Шаг 4: Разбор JSON-ответа ---
    data = response.json()

    if 'error' in data:
        print(f"Ошибка API: {data['error']['error_msg']}")
    else:
        user_info = data['response']
        print("Полученная информация о пользователе:")
        print(json.dumps(user_info, ensure_ascii=False, indent=4))

        # --- Шаг 5: Сохранение в JSON ---
        with open('vk_user_info.json', 'w', encoding='utf-8') as f:
            json.dump(user_info, f, ensure_ascii=False, indent=4)
        print("\nДанные сохранены в vk_user_info.json")

except requests.exceptions.RequestException as e:
    print(f"Ошибка сети: {e}")
except json.JSONDecodeError:
    print("Не удалось декодировать JSON-ответ.")
Этот пример, следующий структуре запросов, описанной в документации VK API 19, показывает гораздо более цивилизованный и предсказуемый способ получения данных по сравнению с парсингом HTML.
Глава 4: От сырых данных к качественным лидам: B2B-стратегия
Эта глава переходит от технических и юридических аспектов к практическому применению собранных данных и присущим этому процессу недостаткам.
4.1 Определение цели: использование должностей и фирмографики для идентификации ЛПР
Сырые данные — просто список имен и компаний — бесполезны без стратегии. Чтобы превратить их в потенциальных лидов, необходимо отфильтровать тех, кто соответствует вашему идеальному профилю клиента (Ideal Customer Profile, ICP). Для этого используются два основных типа данных:
- Демография (в контексте B2B): Характеристики конкретного человека, такие как его должность (например, «Директор по маркетингу»), функциональная роль («Маркетинг», «IT») и уровень в иерархии компании (C-level, VP, Manager).40
- Фирмографика: Характеристики самой компании, такие как отрасль (по кодам ОКВЭД или их аналогам SIC/NAICS), размер компании (количество сотрудников), годовой доход и географическое положение.41
Комбинируя эти данные, можно создать четкий ICP. Например: «Директора по маркетингу (демография) в SaaS-компаниях с штатом от 50 до 200 сотрудников, расположенных в Северной Америке (фирмографика)».40
| Таблица 3: Распространенные должности лиц, принимающих решения (ЛПР), по отделам |
| Отдел |
| Исполнительное руководство |
| Продажи |
| Маркетинг |
| IT / Технологии |
| Финансы |
| Кадры (HR) |
Эта таблица, составленная на основе данных из нескольких источников 45, служит практическим руководством для таргетинга.
4.2 Опасности холодных рассылок: почему ваш спарсенный список может обернуться против вас
Этот раздел — серьезное предостережение о последствиях использования спарсенного списка для холодных рассылок.
- Проблема спама: Отправка нежелательных коммерческих писем — это и есть спам. Даже хорошо составленные и персонализированные письма могут быть восприняты как таковые, если получатель их не запрашивал.
- Репутационный ущерб: Высокий уровень жалоб на спам (любой показатель выше 0.1%, то есть 1 жалоба на 1000 писем, считается высоким) наносит ущерб репутации вашего домена-отправителя.50
- Проблемы с доставляемостью: Поврежденная репутация приводит к тому, что почтовые провайдеры (такие как Google и Microsoft) начинают отправлять ваши письма прямо в папку «Спам» или вовсе блокируют их. Это касается всех писем вашей компании, включая важную переписку с существующими клиентами и партнерами.50
- Низкая конверсия: Холодные письма печально известны своими низкими показателями отклика (в среднем 1%) и конверсии (в SaaS-индустрии может достигать всего 0.03%).52 Соотношение усилий и результата часто бывает удручающим.
Сам акт парсинга для создания списка холодных рассылок порождает саморазрушительный цикл. Метод получения данных (несанкционированный парсинг) напрямую ведет к использованию низкокачественного метода коммуникации (холодная рассылка), который, в свою очередь, наносит ущерб самой инфраструктуре (репутации email-домена), необходимой для его успеха. Вы парсите список из 10 000 контактов без их согласия. Затем вы отправляете им письма. Поскольку контакт «холодный», а рассылка нежелательная, необычно большое число получателей помечает ваше письмо как спам.50 Это сигнализирует почтовым провайдерам, что ваш домен рассылает нежелательную почту. В результате ваша доменная репутация падает, и будущие письма — даже теплым лидам или существующим клиентам — с большей вероятностью попадут в спам. Таким образом, первоначальное действие по сбору данных «отравляет колодец» для всех последующих маркетинговых усилий по электронной почте. Краткосрочная выгода от большого списка оплачивается долгосрочной деградацией критически важного канала коммуникации.
4.3 Скрытый враг: как устаревание данных делает ваш список бесполезным
Это мощный практический аргумент против ценности спарсенного списка. Данные — это не статичный актив.
- Статистика: B2B-данные устаревают с ошеломляющей скоростью. Источники указывают на годовой показатель устаревания от 22.5% до 70%. Более свежие данные за конец 2024 года показали месячный показатель в 3.6%.54
- Причины: Люди меняют работу, получают повышения, компании сливаются или закрываются, меняются адреса электронной почты и номера телефонов.54
- Последствия: Список, спарсенный сегодня, уже через несколько месяцев будет содержать значительный процент недействительных контактов. Это приводит к высокому проценту отказов (email bounces), что еще больше вредит репутации отправителя, а также к впустую потраченным усилиям отдела продаж и упущенным возможностям.54
Устаревание данных — это скрытый «налог» на парсинг. Ценность спарсенного актива начинает обесцениваться немедленно. Это означает, что рентабельность инвестиций (ROI) в эту высокорискованную деятельность постоянно снижается. Представьте, что компания вкладывает время, ресурсы и несет юридические риски, чтобы собрать список из 10 000 контактов. Она считает этот список ценным активом. Но, исходя из консервативного показателя устаревания в 2.1% в месяц 54, уже через полгода более 1200 контактов в этом списке будут неточными. Усилия по очистке и поддержанию этого статичного, устаревающего списка требуют постоянных новых инвестиций — либо через ручную проверку, либо с помощью инструментов обогащения данных. Следовательно, парсинг — это не разовое приобретение актива, а приобретение быстро обесценивающегося пассива, который требует постоянного и дорогостоящего обслуживания, чтобы оставаться хотя бы частично полезным. Это в корне подрывает привлекательность парсинга как «быстрого и дешевого» решения.
Глава 5: Безопасные гавани: мощные альтернативы ручному парсингу
Эта заключительная глава предоставляет читателю действенные, законные и более эффективные решения его основной бизнес-задачи.
5.1 Официальный путь: использование LinkedIn Sales Navigator
Вместо того чтобы пытаться взломать систему, можно использовать инструмент, который LinkedIn создал специально для решения вашей задачи: поиска и установления контактов с ЛПР в B2B.
- Ключевые возможности:
- Расширенный поиск: Более 50 фильтров для поиска лидов и компаний, что значительно превосходит возможности бесплатной версии LinkedIn.58
- Сообщения InMail: Ежемесячный лимит сообщений для связи с людьми вне вашей сети контактов напрямую на платформе.58
- Рекомендации и оповещения о лидах: ИИ-рекомендации и оповещения в реальном времени об активности потенциальных клиентов (например, о смене работы).60
- TeamLink (в плане Advanced): Позволяет увидеть, как ваша команда связана с потенциальным клиентом, что открывает возможности для «теплых» представлений.61
- Интеграция с CRM (в планах Advanced/Plus): Прямая синхронизация данных с Salesforce, HubSpot и другими системами.61
| Таблица 4: Ручной парсинг vs. LinkedIn Sales Navigator — анализ рисков и выгод |
| Фактор |
| Законность/Риск |
| Актуальность данных |
| Стоимость |
| Эффективность |
| Этический статус |
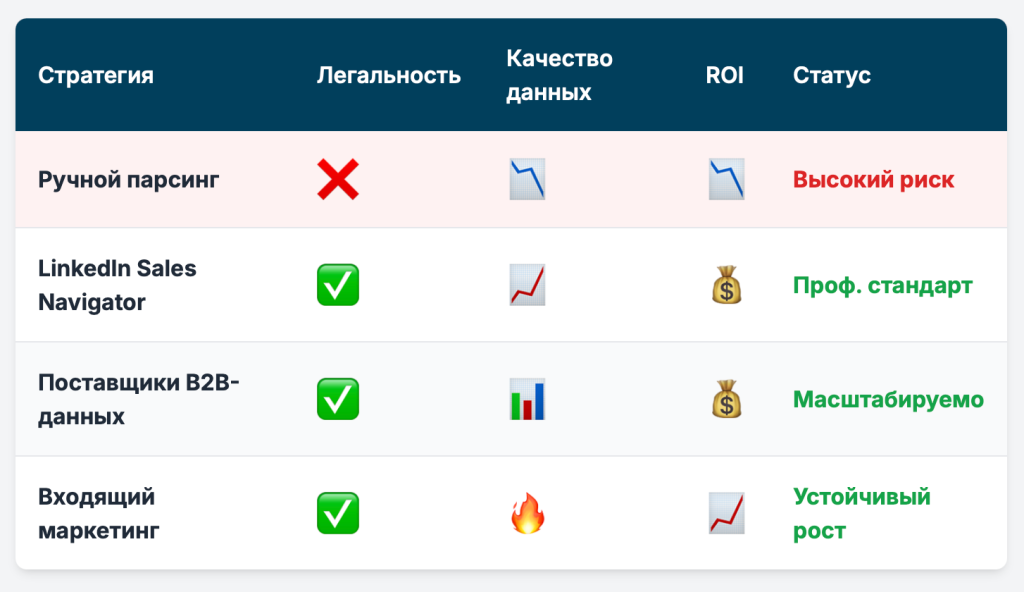
Эта таблица, основанная на анализе рисков из глав 2 и 4 и функциях Sales Navigator 58, наглядно показывает, что Sales Navigator является стратегически более выгодным выбором.
5.2 Аутсорсинговый путь: обзор поставщиков B2B-данных
Альтернативой самостоятельному сбору данных является их покупка у специализированных компаний.
- Как они работают: Компании, такие как ZoomInfo, Cognism, Apollo.io, Dealfront, агрегируют данные из множества источников, включая публичные реестры, парсинг веб-сайтов и иногда данные, предоставленные сообществом. Что критически важно, они берут на себя юридическое бремя обеспечения соответствия требованиям законодательства.64
- Аспект соответствия: Надежные поставщики уведомляют людей, чьи данные находятся в их базе, сверяются со списками «Не звонить» (Do-Not-Call) и соблюдают требования GDPR и CCPA, предлагая своим клиентам уровень юридической защиты.56
- Ключевые возможности: Они предоставляют не просто контактную информацию, но и фирмографику, технографику (какое ПО использует компания) и данные о намерениях (intent data) — сигналы о том, что компания активно ищет решение, подобное вашему.67
Поставщики B2B-данных продают не просто списки; они продают «соответствие законодательству как услугу». Их основное ценностное предложение по сравнению с ручным парсингом — это снижение юридических и комплаенс-рисков. Когда бизнес парсит данные самостоятельно, он становится «контролером данных» и несет полную ответственность за нарушения. Покупая данные у авторитетного поставщика, такого как Cognism 56 или Dealfront 67, компания перекладывает это бремя. Поставщик (теоретически) уже выполнил требование GDPR об уведомлении субъекта данных и установил законное основание для обработки. Ежемесячная плата такому провайдеру — это, по сути, страховой взнос от юридических и репутационных рисков, связанных с самостоятельным сбором данных.
5.3 Устойчивый путь: основы входящей (inbound) лидогенерации
Это самая долгосрочная и устойчивая альтернатива. Вместо того чтобы гоняться за лидами (outbound), вы привлекаете их к себе.
- Основные стратегии:
- Контент-маркетинг и SEO: Создание ценного контента (статьи в блоге, white papers, кейсы), который отвечает на вопросы вашей целевой аудитории. Это строит доверие и привлекает органический трафик из поисковых систем.44
- «Закрытый» контент (Gated Content): Предложение ценного ресурса (например, отраслевого отчета, шаблона) в обмен на контактные данные посетителя. Это лидогенерация, основанная на согласии.70
- Вебинары и онлайн-мероприятия: Демонстрация экспертизы и сбор регистраций от заинтересованной аудитории.44
- Вовлечение в социальных сетях: Использование платформ, таких как LinkedIn, не для парсинга, а для распространения ценного контента, участия в дискуссиях в группах и создания репутации лидера мнений.44
Ключевое преимущество этого подхода в том, что входящие лиды являются «теплыми». Они уже проявили интерес к вашему бренду и, вероятно, имеют проблему, которую вы можете решить. Это приводит к значительно более высоким показателям конверсии и более здоровой и устойчивой воронке продаж по сравнению с холодными рассылками.71
Заключение: парсить или не парсить? Окончательный вердикт для современного B2B-маркетолога
Подводя итог, можно с уверенностью сказать, что, хотя парсинг социальных сетей технически возможен, он является стратегически необоснованной практикой для большинства серьезных компаний.
Сочетание прямых договорных запретов (которые юридически закреплены, как показало дело hiQ), практически непреодолимых барьеров GDPR, сложных технических средств защиты и быстрого устаревания собранных данных делает этот метод крайне рискованным и низкоэффективным.
Вместо того чтобы вкладывать ресурсы в эту серую зону с сомнительной отдачей, современному B2B-маркетологу следует направить свои усилия на законные, эффективные и устойчивые стратегии:
- Для целенаправленных исходящих продаж: использовать официальные инструменты, такие как LinkedIn Sales Navigator.
- Для масштабируемого получения данных: сотрудничать с проверенными поставщиками B2B-данных, которые берут на себя бремя соответствия законодательству.
- Для долгосрочного роста: выстраивать систему входящего маркетинга, которая будет привлекать теплых и заинтересованных лидов.
В конечном счете, выбор между этими подходами — это не просто технический или юридический вопрос. Это фундаментальное решение о бизнес-стратегии: делать ставку на краткосрочные, рискованные тактики или на долгосрочный, устойчивый и репутационно безупречный рост.
Источники
- What Is Web Scraping? A Beginner’s Guide | CrawlNow Blog, дата последнего обращения: июля 29, 2025, https://www.crawlnow.com/blog/what-is-web-scraping
- What Is Web Scraping? | Built In, дата последнего обращения: июля 29, 2025, https://builtin.com/articles/what-is-web-scraping
- What is Web Scraping? The Complete Guide for 2025 — ScraperAPI, дата последнего обращения: июля 29, 2025, https://www.scraperapi.com/web-scraping/
- Exploring Web Scraping Tools: From Extensions to Frameworks — Proxidize, дата последнего обращения: июля 29, 2025, https://proxidize.com/blog/web-scraping-tools/
- Facebook Pages Scraper — Apify, дата последнего обращения: июля 29, 2025, https://apify.com/apify/facebook-pages-scraper
- What is Web Scraping? The Ultimate Beginner Guide — Nimble Way, дата последнего обращения: июля 29, 2025, https://www.nimbleway.com/blog/what-is-web-scraping
- What is a Headless Browser: Top 8 Options for 2025 [Pros vs. Cons] | ScrapingBee, дата последнего обращения: июля 29, 2025, https://www.scrapingbee.com/blog/what-is-a-headless-browser-best-solutions-for-web-scraping-at-scale/
- What is a Headless Browser? Benefits & More | Medium, дата последнего обращения: июля 29, 2025, https://medium.com/@datajournal/what-is-a-headless-browser-32b6092fd980
- Understanding Puppeteer Headless — BrowserStack, дата последнего обращения: июля 29, 2025, https://www.browserstack.com/guide/puppeteer-headless
- Web Scraping & GDPR: Navigating Legal Data Collection — Evomi …, дата последнего обращения: июля 29, 2025, https://evomi.com/blog/web-scraping-gdpr-navigating-legal-data
- GDPR Compliance In Web Scraping — Octoparse, дата последнего обращения: июля 29, 2025, https://www.octoparse.com/blog/gdpr-compliance-in-web-scraping
- Data Scraping + Personal Data = Data Protection Rules Apply — WILLIAM FRY, дата последнего обращения: июля 29, 2025, https://www.williamfry.com/knowledge/data-scraping-personal-data-data-protection-rules-apply/
- Data scraping and compliance — No clearview — (yet)? — Slaughter and May, дата последнего обращения: июля 29, 2025, https://www.slaughterandmay.com/insights/importedcontent/data-scraping-and-compliance-no-clearview-yet/
- Как выполнять скрейпинг LinkedIn: руководство 2025 года — Bright Data, дата последнего обращения: июля 29, 2025, https://ru-brightdata.com/blog/how-tos-ru/linkedin-scraping-guide
- LinkedIn Scraping Guide: Legality, Ethics & Best Practices, дата последнего обращения: июля 29, 2025, https://scrupp.com/blog/linkedin-anti-scraping
- Automated Data Collection — Meta App Development, дата последнего обращения: июля 29, 2025, https://developers.facebook.com/docs/development/terms-and-policies/automated-data-collection/
- – Facebook Terms of Service — Allanti Beauty Institute, дата последнего обращения: июля 29, 2025, https://allantibeauty.ca/facebook-terms-of-service/
- Meta Platform Terms — Meta for Developers — Facebook, дата последнего обращения: июля 29, 2025, https://developers.facebook.com/terms/dfc_platform_terms/
- vk.com API — vk 3.0 documentation, дата последнего обращения: июля 29, 2025, https://vk.readthedocs.io/en/latest/vk-api.html
- VK Data Protection, дата последнего обращения: июля 29, 2025, https://m.vk.com/data_protection?lang=en§ion=rules
- hiQ v. LinkedIn Wrapped Up: Web Scraping Lessons Learned — ZwillGen, дата последнего обращения: июля 29, 2025, https://www.zwillgen.com/alternative-data/hiq-v-linkedin-wrapped-up-web-scraping-lessons-learned/
- hiQ Labs v. LinkedIn — Wikipedia, дата последнего обращения: июля 29, 2025, https://en.wikipedia.org/wiki/HiQ_Labs_v._LinkedIn
- hiQ Labs, Inc. v. LinkedIn Corp. Case Brief Summary | Law Case Explained — YouTube, дата последнего обращения: июля 29, 2025, https://www.youtube.com/watch?v=lzmWAo7_Pgk
- HIQ LABS, INC. V. LINKEDIN CORPORATION, No. 17-16783 (9th Cir. 2022) — Justia Law, дата последнего обращения: июля 29, 2025, https://law.justia.com/cases/federal/appellate-courts/ca9/17-16783/17-16783-2022-04-18.html
- HiQ v. LinkedIn: web scraping case law — Apify Blog, дата последнего обращения: июля 29, 2025, https://blog.apify.com/hiq-v-linkedin/
- LinkedIn v. HiQ and the trans-Atlantic privacy divide — IAPP, дата последнего обращения: июля 29, 2025, https://iapp.org/news/a/linkedin-v-hiq-and-the-transatlantic-privacy-divide
- LinkedIn Scraping: Methods, Challenges, and Best Practices …, дата последнего обращения: июля 29, 2025, https://nodemaven.com/blog/linkedin-scraping/
- 7 Anti-Scraping Techniques (And How to Bypass Them) | Medium, дата последнего обращения: июля 29, 2025, https://medium.com/@datajournal/anti-scraping-techniques-2cba92f700a6
- 10 Best Tips on How to Not Get Blocked When Web Scraping, дата последнего обращения: июля 29, 2025, https://www.scraperapi.com/blog/10-tips-for-web-scraping/
- Guide to LinkedIn Scraping: Techniques & Best Practices — ProxyBros.com, дата последнего обращения: июля 29, 2025, https://proxybros.com/linkedin-scraping/
- Tools and Techniques for Scraping Data from Facebook Groups — ReachOwl, дата последнего обращения: июля 29, 2025, https://reachowl.com/blog/tools-techniques-scraping-data-facebook-groups/
- How to Navigate Facebook Data Scraping: A Guide — Geonode, дата последнего обращения: июля 29, 2025, https://geonode.com/blog/how-to-scrape-facebook
- 10 Best Practices for Web Scraping LinkedIn Without Getting Banned, дата последнего обращения: июля 29, 2025, https://www.wpfastestcache.com/blog/10-best-practices-for-web-scraping-linkedin-without-getting-banned/
- kevinzg/facebook-scraper: Scrape Facebook public pages without an API key — GitHub, дата последнего обращения: июля 29, 2025, https://github.com/kevinzg/facebook-scraper
- premnagdeo/Python-LinkedIn-Information-Scraper … — GitHub, дата последнего обращения: июля 29, 2025, https://github.com/premnagdeo/Python-LinkedIn-Information-Scraper
- How to Scrape Linkedin Profiles With Python Requests and BeautifulSoup — ScrapeOps, дата последнего обращения: июля 29, 2025, https://scrapeops.io/python-web-scraping-playbook/python-scrape-linkedin-profiles/
- How to Scrape Facebook Business Pages from Search in 2024 [No-Code] — lobstr.io, дата последнего обращения: июля 29, 2025, https://www.lobstr.io/blog/scrape-facebook-business-pages-no-code
- facebook-scraper — PyPI, дата последнего обращения: июля 29, 2025, https://pypi.org/project/facebook-scraper/
- VK API — Developer docs, APIs, SDKs, and auth. | API Tracker, дата последнего обращения: июля 29, 2025, https://apitracker.io/a/vk
- Firmographic Data for B2B Lead Generation — Coldlytics, дата последнего обращения: июля 29, 2025, https://www.coldlytics.com/glossary/firmographic-data
- The Ultimate Guide To Firmographic Segmentation | SurveyMonkey, дата последнего обращения: июля 29, 2025, https://www.surveymonkey.com/market-research/resources/ultimate-guide-firmographic-segmentation/
- Firmographic Segmentation: A B2B Marketing Guide — SalesIntel.io, дата последнего обращения: июля 29, 2025, https://salesintel.io/blog/firmographic-segmentation/
- Your Guide to Firmographic Data for B2B Marketing and Sales — Hushly, дата последнего обращения: июля 29, 2025, https://resources.hushly.com/blog-posts/your-guide-to-firmographic-data-for-b2b-marketing-and-sales
- 16 B2B Lead Generation Strategies That WORK — Abstrakt Marketing Group, дата последнего обращения: июля 29, 2025, https://www.abstraktmg.com/b2b-lead-generation-strategies/
- Job Titles — B2B Email Lists By — Kloser, дата последнего обращения: июля 29, 2025, https://www.kloser.com/b2b-email-list-categories/job-titles
- B2B Marketing Job Titles — CUFinder, дата последнего обращения: июля 29, 2025, https://cufinder.io/blog/b2b-marketing-job-titles/
- 101 examples of great job titles in business — PeopleGoal, дата последнего обращения: июля 29, 2025, https://www.peoplegoal.com/blog/job-titles-in-business
- B2B Marketing Manager Job Titles in 2025 — Most Popular Titles by Career Level — Teal, дата последнего обращения: июля 29, 2025, https://www.tealhq.com/job-titles/b2b-marketing-manager
- Can I Filter B2B Data by Job Title? Yes — Here’s How — Results Driven Marketing, дата последнего обращения: июля 29, 2025, https://rdmarketing.co.uk/?post_type=post&p=21957
- Cold Emails vs. Spam: Why Your Outreach Gets Spam Reported (10 Causes & Fixes), дата последнего обращения: июля 29, 2025, https://www.allegrow.co/knowledge-base/cold-emails-reported-as-spam
- Agency Outreach: How to Protect Sender Reputation with Cold Email? — Woodpecker, дата последнего обращения: июля 29, 2025, https://woodpecker.co/blog/agency-outreach-sender-reputation/
- 20+ Cold Email Statistics and Insights You Should Know — Mailmodo, дата последнего обращения: июля 29, 2025, https://www.mailmodo.com/guides/cold-email-statistics/
- Cold Email Conversion Rate: Stats and Tips for Success — Instantly.ai, дата последнего обращения: июля 29, 2025, https://instantly.ai/blog/cold-email-conversion-rate/
- What is B2B Data Decay and How It Is Impacting Your Business, дата последнего обращения: июля 29, 2025, https://www.smarte.pro/blog/b2b-data-decay
- The Alarming Rise in B2B Email Decay: What It Means for Your Data, Sales, Marketing, and Ops Teams — RevenueBase, дата последнего обращения: июля 29, 2025, https://revenuebase.ai/b2b-email-decay-what-it-means-for-your-data-sales-marketing-and-ops-teams/
- Data Decay & Degradation: The True Impact on Your Business, дата последнего обращения: июля 29, 2025, https://www.cognism.com/blog/data-decay
- Database Decay Simulation — HubSpot, дата последнего обращения: июля 29, 2025, https://www.hubspot.com/database-decay
- Your Guide to LinkedIn Sales Navigator Pricing (2025) — SalesBread, дата последнего обращения: июля 29, 2025, https://salesbread.com/linkedin-sales-navigator-plans-and-pricing-comparison/
- Sales Tool | LinkedIn Sales Navigator — LinkedIn Business Solutions, дата последнего обращения: июля 29, 2025, https://business.linkedin.com/sales-solutions/sales-navigator
- LinkedIn Sales Navigator Cost: Is It Really Worth it? | Factors Blog, дата последнего обращения: июля 29, 2025, https://www.factors.ai/blog/linkedin-sales-navigator-cost
- How Much LinkedIn Sales Navigator Costs? [2025 Pricing] — Evaboot, дата последнего обращения: июля 29, 2025, https://evaboot.com/blog/how-much-does-linkedin-sales-navigator-cost
- Compare Plans and Pricing | LinkedIn Sales Navigator — LinkedIn Business Solutions, дата последнего обращения: июля 29, 2025, https://business.linkedin.com/sales-solutions/compare-plans
- LinkedIn Sales Navigator Cost: 2025 Pricing Guide — Skrapp, дата последнего обращения: июля 29, 2025, https://skrapp.io/blog/linkedin-sales-navigator-cost-and-pricing/
- www.cognism.com, дата последнего обращения: июля 29, 2025, https://www.cognism.com/blog/what-is-zoominfo#:~:text=ZoomInfo%20gets%20its%20data%20from,through%20their%20business%20email%20address.
- How does Zoominfo get their data? — Lead411, дата последнего обращения: июля 29, 2025, https://www.lead411.com/blog/how-does-zoominfo-get-their-data/
- What is ZoomInfo & How Do They Get Their Data?, дата последнего обращения: июля 29, 2025, https://www.vendr.com/blog/what-is-zoominfo
- The 22 Best B2B Data Vendors and Providers in 2025 | Dealfront — en, дата последнего обращения: июля 29, 2025, https://www.dealfront.com/blog/data-vendors/
- Best 18 B2B Data Providers in 2025 (Ranked & Reviewed) — Generect, дата последнего обращения: июля 29, 2025, https://generect.com/blog/b2b-data-provider/
- How To Boost Lead Generation Using Content Marketing — VWO, дата последнего обращения: июля 29, 2025, https://vwo.com/blog/boost-lead-generation-content-marketing/
- 8 Steps to a Lead-Generating Content Marketing Strategy — WordStream, дата последнего обращения: июля 29, 2025, https://www.wordstream.com/blog/ws/2021/07/13/content-marketing-strategy
- What is B2B lead generation? 15 proven strategies for growth — Zendesk, дата последнего обращения: июля 29, 2025, https://www.zendesk.com/blog/b2b-lead-gen/